人工智能与伦理 如何确保AI应用中的隐私保护——面向智能应用软件开发者的实践指南
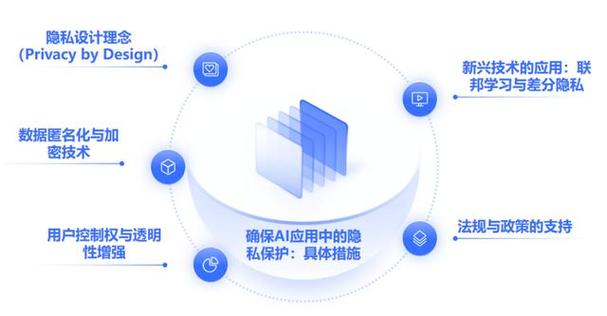
引言\n\n人工智能(AI)正以前所未有的速度渗透到医疗、金融、教育、社交等各个领域。智能应用软件在带来便利与效率的也引发了严峻的隐私保护挑战。用户的身份信息、行为轨迹、生物特征甚至情感倾向,都可能被无感采集和深度分析。如果缺乏伦理约束与隐私保护机制,AI应用很可能沦为隐私侵蚀的工具。因此,在智能应用软件开发的全生命周期中,融入隐私保护理念,不仅是法律合规的要求,更是技术伦理的底线。本文将探讨AI应用中隐私风险的核心来源,并提出可落地于软件开发实践的隐私保护策略。\n\n## 一、AI应用中的隐私风险\n\n### 1. 数据采集阶段的过度收集\n许多智能应用为了训练模型,倾向于收集尽可能多的数据,包括通讯录、位置、相册等与核心功能无关的信息。用户往往在“一键授权”中失去对自己数据的控制权。\n\n### 2. 模型训练与推断过程中的泄露\nAI模型可能通过反向攻击从梯度更新、API输出或模型参数中还原出训练数据中的敏感信息。例如,攻击者可以通过成员推断攻击判断某个特定用户是否出现在训练集中。\n\n### 3. 数据共享与第三方SDK的失控\n智能应用常集成广告、统计、支付等第三方SDK,数据在多个主体之间流转,形成复杂的隐私风险链。一旦某个环节被攻破,用户的隐私便可能被大规模泄露。\n\n### 4. 自动化决策带来的标签化与歧视\n基于用户画像的自动化推荐或评分,容易形成“信息茧房”或“信用不公”,本质上也是一种隐性的隐私滥用——用户不知情地被贴上标签并承担后果。\n\n## 二、伦理原则:隐私保护的价值基础\n\n为确保AI应用尊重用户隐私,软件开发应遵循以下伦理原则:\n\n- 知情同意:确保用户充分理解数据用途后自愿授权,反对默认勾选与诱导分享。\n- 最小必要:只采集与核心功能直接相关的最小数据集,用完即删或匿名化。\n- 目的限制:数据使用不应超出用户同意的范围,严禁私下二次利用。\n- 透明可控:用户应能随时查看、更正、删除自己的数据,并了解算法决策的逻辑。【【】终于采用解释这一核心原则呢?重要后果。】\n- 责任可追溯:开发者需对AI系统的隐私表现负责,建立审计与问责机制”\n\n## 三、智能应用软件开发中的隐私保护实践\n\n### 1. 将隐私保护嵌入开发生命周期(PbD)\n“隐私设计”(Privacy by Design)强调在系统架构的起始阶段就考虑隐私风险关键实践活动包括数据映射、隐私影响评估、威胁建模。开发团队应定期更新隐私风险评估文档并在CI/CD()中加入隐私合规测试Gate阈值)\n\n### 2,采用隐私增强技术()\\nPETs为兼顾Data Utility与IA打造技术底座技术在端侧纵向联邦学习|Model Personalization),开发人员凭轻量库部署。如(医学影像)安卓TensorFlow Lite私…\n-举例差分隐私-->add LaplaceGaussian严格测库:适用于模型(端统计特征?)) →上传 noisy 而非 raw dataGoogle的Gboard}\nImplement 应用下显著Min确保rate定义严格,delta高保证器:Renyi DP--use Opacus\n(Federated\rMAC保护机制上传深度(Masking & mask=self物协商结合 MPC)\non\text:I especially 敏感:sign encryption确保Agg只要irrecover防inversion query与与 data sh。”\n\n降明确且精确,且明却无)。至多四:本文必须)”,但对 API严格 user._)\n.\
如若转载,请注明出处:http://www.rsy7.com/product/29.html
更新时间:2026-10-24 22:13:57